
Cuando empecé a programar, una de las cosas que más me confundía no era necesariamente escribir código.
Era entender qué estaba haciendo el ordenador con aquello que yo escribía.
Comandos aparentemente sencillos como:
pwd
cd
mkdir
touch
parecían simplemente palabras que tenía que memorizar.
Sabía que pwd mostraba un directorio, que cd cambiaba de directorio, que mkdir creaba un directorio y que touch podía crear un archivo. Pero seguía teniendo una pregunta:
¿Qué ocurre realmente después de que pulso Enter?
Y esta pregunta nos lleva a otra aún más importante:
¿Cómo ejecuta un programa el ordenador?
La respuesta implica mucho más que simplemente «la CPU ejecuta el código».
Existe una secuencia que involucra al terminal, al shell, al sistema operativo, los procesos, los archivos ejecutables, el loader, la memoria virtual, el runtime, el entry point, los registros y la CPU.
En este artículo, construiremos esta explicación paso a paso.
Antes del programa: ¿qué ocurre cuando utilizas el terminal?

Empecemos por algo que probablemente ya hayas hecho.
En Linux, podemos abrir un terminal y ejecutar:
pwdEl comando muestra el directorio actual.
Después:
mkdir proyectoCreamos un directorio llamado proyecto.
Podemos entrar en él:
cd proyectoY crear un archivo:
touch programa.txtA primera vista, parece que el terminal simplemente «entiende» estas palabras.
Pero no funciona de esa manera.
Cuando escribes:
mkdir proyectohay un programa llamado shell involucrado en esta interacción.
El shell es el programa que recibe los comandos que escribes y coordina su ejecución.
En Linux, algunos ejemplos habituales de shell son Bash, Zsh y otros.
En Windows, podemos utilizar entornos como PowerShell.
Esto ya nos da una primera idea importante:
El terminal es el entorno en el que interactuamos; el shell es el programa que interpreta nuestra entrada y participa en la ejecución de los comandos.
Y aquí comienza nuestro recorrido.
¿Qué ocurre cuando pulsamos Enter?
Imagina que escribes:
mkdir proyectoy pulsas Enter.
Una representación simplificada del proceso es:
Tú
  ↓
Terminal
  ↓
Shell
  ↓
Sistema operativo
  ↓
Operación solicitada
  ↓
Sistema de archivos
El detalle importante es que no todos los comandos funcionan exactamente de la misma manera.
Algunos comandos pueden estar implementados en el propio shell como built-ins.
Por ejemplo, normalmente cd debe ser gestionado por el propio shell, porque cambiar el directorio de trabajo del proceso del shell es precisamente lo que permite que los siguientes comandos se ejecuten desde ese directorio.
Otros comandos pueden ser programas independientes.
La idea central es:
escribir algo en el terminal no significa que la CPU haya recibido directamente ese texto como una instrucción de máquina.
Existe una capa de software entre tú y el procesador.
Y esta idea será importante cuando lleguemos a la ejecución de programas.
Programa y proceso no son lo mismo
Esta es una de las distinciones más importantes de este artículo.
Imagina que tienes un archivo ejecutable.
Ese archivo es un programa almacenado.
Cuando el sistema operativo empieza a ejecutarlo, tenemos un proceso.
Una forma sencilla de entenderlo es:
Programa
= algo almacenado

Proceso
= una instancia de ese programa en ejecución
Por ejemplo, puedes tener instalado en el ordenador el archivo ejecutable de un editor de texto.
El archivo existe en el almacenamiento incluso cuando el editor está cerrado.
Cuando abres el editor, el sistema operativo crea una instancia en ejecución.
Esta instancia tiene sus propios recursos, como espacio de direcciones virtuales, información de ejecución, memoria e identificadores.
En Linux, por ejemplo, los procesos tienen un PID, el identificador del proceso.
Por lo tanto:
archivo ejecutable
       ↓
   carga
       ↓
    proceso
       ↓
   ejecución
Esta diferencia resuelve una confusión habitual entre quienes están empezando:
el archivo del disco no es lo mismo que el proceso que se está ejecutando.
¿Qué es un archivo ejecutable?
Un archivo ejecutable no es simplemente un archivo de texto que contiene comandos.
Tiene una estructura que permite al sistema operativo descubrir la información necesaria para ponerlo en ejecución.
Según el sistema operativo y la plataforma, pueden utilizarse distintos formatos.
En Linux, uno de los principales es ELF — Executable and Linkable Format.
En Windows, encontramos PE — Portable Executable.
En el ecosistema de Apple existe Mach-O.
Estos formatos contienen información estructural que ayuda al sistema a entender cómo debe utilizarse el archivo.
En el caso de PE, por ejemplo, la documentación de Microsoft describe encabezados, tablas de secciones, información de importación y exportación, y datos necesarios para la imagen ejecutable.
En ELF, la estructura de los program headers describe segmentos relacionados con la creación de la imagen del proceso, incluida la información necesaria para cargar el programa y preparar su representación en memoria.
Es importante notar el cambio de perspectiva:
No es simplemente:

"archivo con código"

Es:

"archivo estructurado que contiene la información
necesaria para formar un programa en ejecución"
ELF, PE y Mach-O
Los formatos no son simplemente tres nombres diferentes para exactamente lo mismo.
Pertenecen a ecosistemas distintos.
| Sistema/ecosistema | Formato habitual |
|---|---|
| Linux/Unix-like | ELF |
| Windows | PE |
| Apple | Mach-O |
ELF se utiliza en muchos sistemas Unix-like y describe tanto archivos objeto como ejecutables y objetos compartidos.
PE es el formato utilizado para imágenes ejecutables y otros archivos relacionados en Windows. La propia Microsoft documenta su estructura en términos de encabezados, secciones, directorios de datos, importaciones y reubicaciones.
Mach-O se utiliza en el ecosistema de Apple. La documentación de Apple, por ejemplo, aborda las arquitecturas de código ejecutable compatibles con un bundle y su carga.
Para nuestro objetivo, no necesitamos memorizar todos los campos de estos formatos.
Necesitamos entender por qué existen.
El sistema operativo necesita información estructurada para transformar el contenido almacenado en una imagen de proceso que pueda ejecutarse.
¿Qué hace el loader?
Ahora llegamos a una pieza fundamental:
el loader.
El loader participa en el proceso de transformar el ejecutable almacenado en una representación que el proceso pueda ejecutar.
Imagina lo siguiente:
Ejecutable en el almacenamiento
           ↓
         Loader
           ↓
Imagen del proceso en memoria
           ↓
        Ejecución
En ELF, la especificación describe precisamente esta relación entre el archivo y la creación de una representación dinámica del programa, llamada process image. Los segmentos descritos por los program headers se utilizan para preparar esta imagen en memoria.
Esto es muy importante.
El ordenador no se limita a coger todo el archivo y «meterlo en la RAM».
Necesita interpretar su estructura y preparar distintas regiones del espacio de direcciones del proceso.
Además, los programas suelen depender de bibliotecas compartidas y otras estructuras que también deben participar en la inicialización.
¿Cómo se organiza el programa en la memoria?
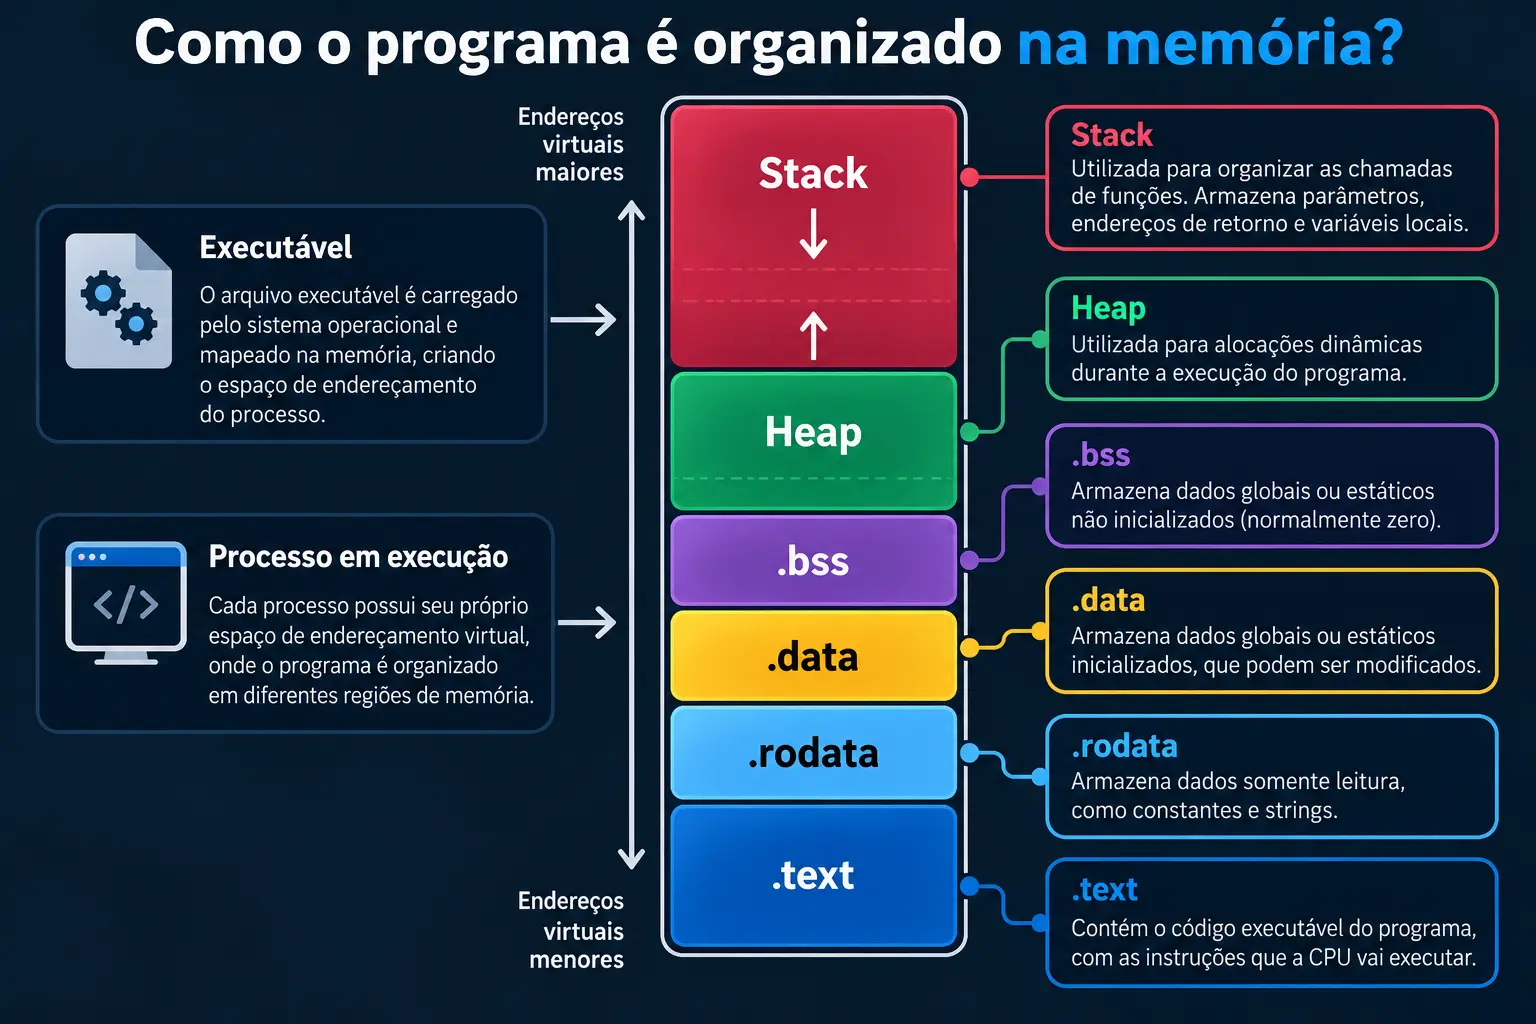
Cuando un proceso está en ejecución, su espacio de memoria no es simplemente una gran caja sin organización.
Existen distintas regiones con funciones diferentes.
Una representación didáctica es:
Direcciones virtuales más altas
┌─────────────────────────┐
│          Stack          │
│           ↓             │
│                         │
│                         │
│           ↑             │
│          Heap           │
├─────────────────────────┤
│ Datos inicializados     │
│ .data                   │
├─────────────────────────┤
│ Datos de solo lectura   │
│ .rodata                 │
├─────────────────────────┤
│ Datos no inicializados  │
│ .bss                    │
├─────────────────────────┤
│ Código                  │
│ .text                   │
└─────────────────────────┘
Direcciones virtuales más bajas
Esta representación es conceptual. La organización real depende de la plataforma, del formato del ejecutable, del compilador, del linker, del sistema operativo y de otros factores.
Aun así, ayuda a entender las responsabilidades.
.text: dónde se encuentra el código
La región .text suele estar asociada al código ejecutable del programa.
Allí encontramos las instrucciones que, en algún momento, podrá ejecutar la CPU.
Por ejemplo, una función escrita en un lenguaje de programación acaba, directa o indirectamente, representada mediante instrucciones que el procesador puede ejecutar.
Pero todavía existe una enorme diferencia entre:
print("Hola")y lo que la CPU ejecuta realmente.
La CPU no recibe la palabra print como una instrucción nativa.
Existe una cadena de software entre el lenguaje que utilizamos y las instrucciones de la arquitectura del procesador.
En este artículo, nuestro objetivo no es profundizar en esa transformación, sino entender qué ocurre cuando ya existe código ejecutable que puede cargarse y ejecutarse.
.data, .rodata y .bss
Además del código, el programa puede necesitar almacenar datos.
.data
Suele estar asociada a datos globales o estáticos que tienen valores inicializados y pueden modificarse.
.rodata
El nombre procede de read-only data.
Se utiliza para datos que deben tratarse como de solo lectura en muchas cadenas de herramientas, como determinadas constantes y cadenas de texto.
.bss
Tradicionalmente, está asociada a datos globales o estáticos que no necesitan ocupar un espacio equivalente en el archivo para representar sus valores iniciales, normalmente cero.
Estas regiones ayudan a mostrar algo importante:
Un programa en ejecución es mucho más que sus instrucciones.
Necesita código, datos, memoria para las llamadas a funciones, asignación dinámica y diversas estructuras de soporte.
Memoria virtual: la dirección que ve el programa
Aquí aparece un concepto que suele causar bastante confusión al principio:
memoria virtual.
Cuando un programa accede a una dirección, esta forma parte del espacio de direcciones virtuales del proceso.
Esto no significa necesariamente que ese número corresponda directamente a una posición física específica de la RAM.
El sistema utiliza mecanismos de memoria virtual para asignar direcciones virtuales a memoria física y otros recursos.
En Linux, es posible observar las regiones de memoria asignadas a un proceso mediante /proc/PID/maps. La documentación del kernel describe este archivo como el que contiene las regiones de memoria actualmente asignadas y sus permisos.
Por ejemplo, una salida puede contener regiones identificadas como:
[heap]
[stack]
y también regiones asociadas a archivos y bibliotecas.
Esto hace que el concepto sea mucho más concreto:
el proceso tiene un espacio de direcciones organizado, y el sistema operativo gestiona las asignaciones de ese espacio.
Stack y Heap
Dos términos aparecen prácticamente en cualquier conversación sobre memoria:
stack y heap.
Stack
La stack se utiliza para organizar los datos relacionados con la ejecución de las funciones.
Cuando una función llama a otra, hay una serie de datos que deben conservarse: parámetros, direcciones de retorno y otra información necesaria para la ejecución.
La stack ayuda a organizar este tipo de información.
Heap
El heap está asociado a la memoria utilizada para las asignaciones dinámicas.
Cuando un programa necesita obtener memoria durante su ejecución, los mecanismos de asignación pueden utilizar el heap.
La diferencia, de forma simplificada, es:
Stack
→ organización de las llamadas durante la ejecución

Heap
→ memoria dinámica
No pienses en ellos como dos «cajones físicos» dentro de la RAM.
Son regiones conceptuales del espacio de memoria del proceso.
Entry Point: ¿dónde comienza la ejecución?
Ahora llegamos a una pregunta interesante:
Si el ejecutable tiene miles o millones de bytes, ¿por dónde empieza el ordenador?
Aquí es donde entra el Entry Point.
El ejecutable contiene información que indica el punto inicial de la imagen ejecutable.
Esta dirección permite iniciar la ejecución desde una posición conocida.
Pero hay un matiz importante.
El entry point no tiene por qué ser simplemente la primera línea de la función que has escrito.
Antes de que se ejecute tu código principal, puede haber una fase de inicialización que incluya el runtime, las bibliotecas, la preparación del entorno y los argumentos.
Por eso, conceptos como:
Entry Point
Runtime
main()
no deben tratarse como sinónimos.
Según el lenguaje y la plataforma, existe una cadena de inicialización antes de llegar al código que reconocemos como «nuestro programa».
¿Qué es el runtime?
Runtime significa, en términos generales, el conjunto de mecanismos necesarios durante la ejecución de un programa.
Según el lenguaje y el entorno, el runtime puede encargarse de distintas responsabilidades.
Puede participar en la inicialización del programa, la gestión de estructuras, el soporte del lenguaje, el tratamiento de excepciones, los hilos, la memoria y otras operaciones.
Por eso, cuando pensamos:
«Escribí una función y el ordenador la ejecutó».
existe una cantidad considerable de infraestructura entre ambas cosas.
El código que has escrito forma parte de un entorno de ejecución mucho más amplio.
Bibliotecas compartidas
Otro detalle importante aparece cuando el programa depende de código externo.
En lugar de incluir absolutamente todo dentro del ejecutable, los sistemas pueden utilizar bibliotecas compartidas.
Esto permite que distintos programas utilicen componentes comunes.
Durante la carga, estas bibliotecas pueden asignarse al espacio de direcciones del proceso.
En Linux, por ejemplo, /proc/PID/maps puede mostrar regiones de memoria asociadas a bibliotecas cargadas. La documentación del kernel muestra precisamente asignaciones de archivos y regiones como el heap y la stack dentro de este espacio.
Esto explica por qué la ejecución de un programa puede implicar mucho más que un único archivo.
¿Y qué es la reubicación?
Ahora tenemos otro concepto importante:
la reubicación.
Un programa puede contener referencias que deben ajustarse cuando se coloca en una dirección determinada o cuando es necesario conectar distintos componentes.
La reubicación es uno de los mecanismos utilizados para resolver este tipo de situaciones.
En el formato PE, por ejemplo, la especificación de Microsoft documenta la información de base relocations.
En ELF, el proceso de preparar la imagen del programa también implica resolver referencias entre los objetos que componen el proceso.
Para alguien que está empezando, no es necesario memorizar cada tipo de reubicación.
La idea principal es:
la dirección representada en el archivo y la dirección utilizada realmente durante la ejecución pueden requerir ajustes.
¿Y dónde entra el kernel?
Hasta ahora hemos hablado bastante del programa.
Ahora tenemos que fijarnos en el sistema operativo.
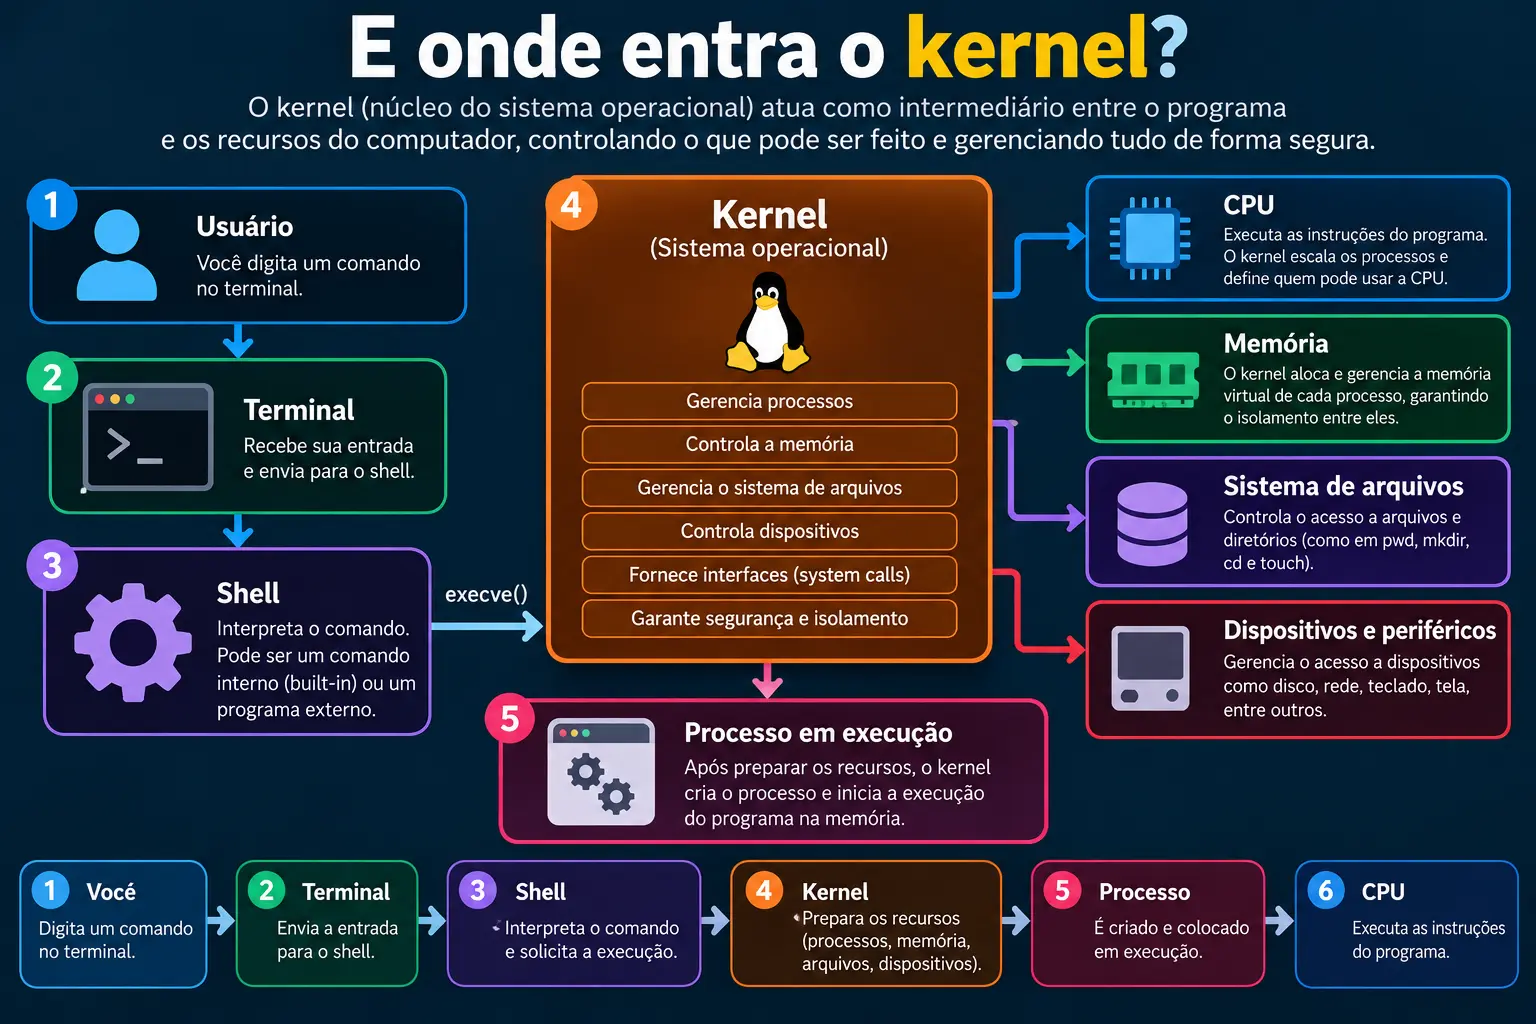
El kernel es el núcleo del sistema operativo y tiene responsabilidades fundamentales relacionadas con la gestión de los recursos del ordenador.
Cuando un programa necesita interactuar con recursos controlados por el sistema operativo, no accede directamente a todo.
Existen interfaces entre el programa y el kernel.
En Linux, por ejemplo, una de estas interfaces fundamentales son las system calls.
Un ejemplo clásico es execve.
La documentación de Linux describe execve() como la llamada que ejecuta el programa indicado por la ruta, sustituyendo la imagen del proceso que realiza la llamada por una nueva imagen de programa, con la stack, el heap y los segmentos de datos inicializados de nuevo.
Esto es una pieza fundamental para entender la ejecución.
Un detalle importante sobre el shell
Volvamos a nuestro terminal.
Escribes:
./programaEl shell no toma el texto ./programa y se lo entrega directamente a la CPU.
Existe una secuencia de operaciones.
De forma simplificada:
Escribes ./programa
          ↓
El shell interpreta el comando
          ↓
El sistema operativo recibe una solicitud
          ↓
Se localiza el programa
          ↓
Se analiza el ejecutable
          ↓
Se prepara la imagen del proceso
          ↓
Se configura la memoria
          ↓
Se preparan las bibliotecas y el runtime
          ↓
Comienza la ejecución
En Linux, execve() es una de las interfaces fundamentales de esta transición.
Esto es muy diferente de la idea inicial:
«Escribí un comando y el ordenador lo ejecutó».
En realidad, se puso en marcha toda una cadena de operaciones.
¿Cómo ejecuta realmente el programa la CPU?
Ahora llegamos al último punto de nuestro recorrido.
CPU.
Una vez que el programa está preparado para ejecutarse, el procesador comienza a ejecutar instrucciones de la arquitectura para la que se creó ese código.
Estas instrucciones se representan a nivel de máquina mediante secuencias de bits y bytes.
Una instrucción puede representarse mediante un opcode y otros campos que determinan la operación, los operandos y los modos de direccionamiento, según la arquitectura.
La CPU trabaja con registros, que son pequeñas áreas de almacenamiento internas del procesador y que se utilizan para diversos fines durante la ejecución.
Entre otras cosas, existe un registro o mecanismo arquitectónico relacionado con la dirección de la siguiente instrucción que debe ejecutarse.
La idea simplificada es:
Memoria
  ↓
Instrucción
  ↓
CPU
  ↓
Decodificación
  ↓
Ejecución
  ↓
Resultado
  ↓
Siguiente instrucción
Desde una perspectiva simplificada, podemos imaginar el ciclo así:
buscar
  ↓
decodificar
  ↓
ejecutar
  ↓
avanzar
  ↓
buscar de nuevo
La implementación real de las CPU modernas es mucho más sofisticada e incluye pipeline, ejecución fuera de orden, cachés, predicción de saltos y otros mecanismos.
Pero esta simplificación es suficiente para entender la idea fundamental:
La CPU no ejecuta directamente el archivo ejecutable en su conjunto. Ejecuta instrucciones de máquina desde el espacio de memoria preparado para el proceso.
Entonces, ¿qué es un opcode?
El opcode identifica la operación que representa una instrucción de máquina.
Imagina una instrucción conceptual como:
sumarLa CPU no recibe la palabra «sumar» como texto.
La arquitectura define una representación binaria para las instrucciones.
Según la arquitectura, los bytes pueden representar operaciones como:
mov
add
sub
jmp
call
ret
Los nombres anteriores son representaciones en ensamblador utilizadas por los seres humanos.
La CPU trabaja con la codificación binaria definida por la arquitectura.
En este punto, por fin podemos conectar la programación de alto nivel con el hardware:
Código que escribes
        ↓
Software / herramientas
        ↓
Código ejecutable
        ↓
Instrucciones de máquina
        ↓
CPU
¿Y los registros?
Los registros son fundamentales para la ejecución.
Una CPU tiene distintos registros con funciones diferentes.
Algunos pueden almacenar valores temporales.
Otros pueden participar en operaciones aritméticas.
Otros tienen funciones específicas relacionadas con el control de la ejecución.
Por ejemplo, la arquitectura puede tener un registro utilizado para seguir la ubicación de la siguiente instrucción.
Esto ayuda a entender algo importante:
la CPU no trabaja únicamente con la memoria RAM.
Tiene un estado interno.
Durante la ejecución, ese estado cambia continuamente.
ABI: ¿cómo se comunican las distintas partes del software?
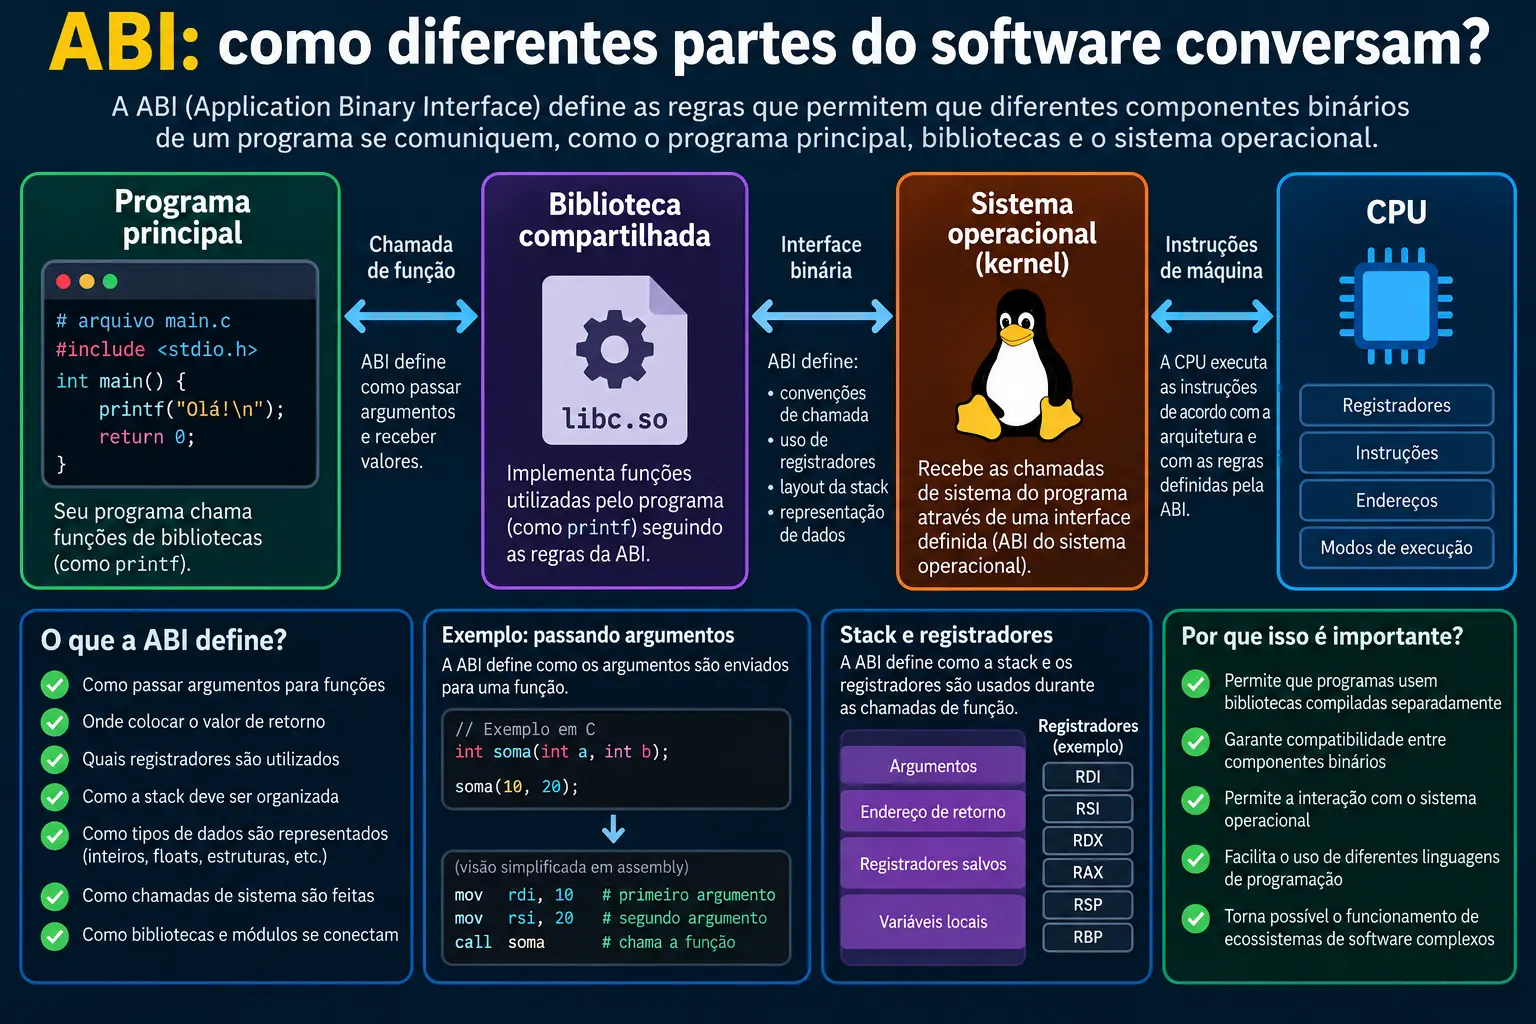
Otro concepto que aparece cuando descendemos a este nivel es la ABI — Application Binary Interface.
La ABI define reglas importantes sobre cómo interactúan los componentes binarios.
Puede establecer, entre otras cosas:
-
cómo se pasan los argumentos;
-
dónde se colocan los valores de retorno;
-
qué registros tienen determinadas responsabilidades;
-
cómo funcionan las llamadas a funciones;
-
cómo se representan determinados tipos.
Esto es importante porque un programa no necesariamente funciona de forma aislada.
Puede llamar a bibliotecas.
Las bibliotecas pueden llamar a otras bibliotecas.
Los distintos componentes necesitan ponerse de acuerdo sobre determinadas reglas.
La ABI ayuda a establecer este contrato.
¿Dónde entran Python y Rust?
Ahora podemos volver a los lenguajes de programación.
Cuando escribes:
print("Hola")o un pequeño programa en Rust, trabajas en una capa mucho más cercana al desarrollador que a la CPU.
Estos lenguajes proporcionan abstracciones para que no tengas que escribir manualmente todas las instrucciones de máquina.
En el caso de Rust, existe una relación especialmente interesante con los ejecutables nativos y los sistemas de bajo nivel.
Pero esto no significa que Rust o Python sean «lo que entiende el ordenador».
A nivel de CPU, el ordenador trabaja con las instrucciones definidas por la arquitectura del procesador.
El lenguaje es una de las capas que utilizamos para producir o controlar software que, en algún momento, llegará a las instrucciones ejecutables.
En este artículo, no necesitamos convertirlo en una discusión sobre compiladores frente a intérpretes.
El objetivo es comprender las distintas capas.
¿Y dónde entra LUME?
LUME puede situarse dentro de esta misma perspectiva como un concepto relacionado con el ecosistema que estás estudiando.
No cambia la secuencia fundamental que intentamos comprender:
programa
  ↓
sistema operativo
  ↓
proceso
  ↓
memoria
  ↓
instrucciones
  ↓
CPU
Lo más importante para quien está empezando es no intentar memorizar todos los nombres de una sola vez.
Primero, comprende la relación entre las distintas capas.
Después podrás profundizar en cada una de ellas.
El recorrido completo: del terminal a la CPU
Ahora podemos unirlo todo.
Imagina que tienes un programa ejecutable y ejecutas:
./programaEl recorrido conceptual es:
┌─────────────────────────┐
│           Tú            │
│ escribes en el terminal │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│        Terminal         │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│          Shell          │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│    Sistema operativo    │
│         / kernel        │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│       Ejecutable        │
│        ELF / PE         │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│         Loader          │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│         Proceso         │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│     Memoria virtual     │
│ .text .data .bss heap   │
│       stack, etc.       │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│   Runtime / inicializ.  │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│      Entry Point        │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│ Instrucciones de máquina│
│       / opcodes         │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│       Registros         │
│          + CPU          │
└─────────────────────────┘
Este es el mapa mental que merece la pena recordar.
¿Dónde encajan pwd, cd, mkdir y touch en todo esto?
Ahora podemos volver a la dificultad que motivó este artículo.
Empezaste aprendiendo comandos como:
pwd
cd
mkdir
touch
Y quizá te pareció que el objetivo era simplemente memorizar:
pwd   → muestra el directorio
cd    → cambia de directorio
mkdir → crea un directorio
touch → crea un archivo
Pero ahora podemos ver estos comandos de otra manera.
Son una puerta de entrada para comprender el ordenador.
Cuando escribes un comando, hay un software que recibe tu entrada.
Ese software interactúa con el sistema operativo.
El sistema operativo gestiona los recursos.
Los procesos tienen memoria y estado.
Los ejecutables tienen formatos estructurados.
El loader prepara los programas para su ejecución.
La memoria virtual organiza el espacio de direcciones.
El runtime puede preparar el entorno de ejecución.
El entry point indica dónde comienza la ejecución.
Y, finalmente, la CPU ejecuta instrucciones de máquina.
Por eso, aprender a utilizar el terminal no debería consistir únicamente en memorizar comandos.
El terminal puede ser una ventana para comprender cómo funciona el sistema operativo.
La principal diferencia entre «programa» y «proceso»
Si solo vas a recordar una distinción de este artículo, recuerda esta:
Programa
→ código y datos almacenados

Proceso
→ programa en ejecución + estado + recursos
Un mismo programa puede dar lugar a varios procesos.
Por ejemplo, puedes abrir varias instancias de una aplicación.
El archivo ejecutable sigue siendo un archivo.
Cada ejecución crea una instancia con su propio contexto de ejecución.
Qué debes recordar
No necesitas terminar este artículo memorizando todas las estructuras de ELF, todos los campos de PE ni todos los registros de una CPU.
El primer objetivo es construir un mapa mental.
Cuando ejecutes un programa, piensa en lo siguiente:
1. Existe alguna forma de solicitar la ejecución.
En el terminal, esto puede ocurrir a través del shell.
2. Existe un archivo u otro mecanismo que representa el programa.
En los sistemas tradicionales, los ejecutables tienen formatos estructurados como ELF o PE.
3. El sistema operativo participa en la creación de la ejecución.
Necesita preparar los recursos y la memoria del proceso.
4. El loader prepara la imagen del programa.
Partes del ejecutable y las bibliotecas necesarias pueden asignarse al espacio de direcciones.
5. El proceso tiene memoria virtual.
El código, los datos, el heap, la stack y otras regiones forman parte de ese espacio.
6. Existe un punto de inicio.
El entry point participa en la definición del lugar donde comienza la ejecución.
7. El software inicializa su entorno.
El runtime y otras estructuras pueden participar en esta fase.
8. La CPU ejecuta instrucciones.
A partir de ahí, entramos en el nivel de los opcodes, los registros y la arquitectura del procesador.
El recorrido completo puede resumirse así:
Terminal
   ↓
Shell
   ↓
Sistema operativo
   ↓
Ejecutable
   ↓
Loader
   ↓
Proceso
   ↓
Memoria virtual
   ↓
Runtime
   ↓
Entry Point
   ↓
Instrucciones
   ↓
CPU
Y esta secuencia es mucho más útil que memorizar definiciones aisladas.
Conclusión
El gran cambio de perspectiva es este:
Cuando escribes:
mkdir proyectoo:
./programano estás simplemente «enviando una orden a la CPU».
Existe toda una arquitectura entre tú y el procesador.
Interactúas con un terminal.
El shell participa en la interpretación y ejecución de los comandos.
El sistema operativo gestiona los recursos.
El ejecutable tiene una estructura.
El loader prepara el programa.
Se crea o transforma un proceso para ejecutar esa imagen.
La memoria virtual organiza el espacio utilizado por el proceso.
El runtime y las bibliotecas pueden participar en la inicialización.
El entry point define un punto de inicio de la ejecución.
Y, finalmente, la CPU trabaja con instrucciones, registros y datos.
Por eso, conceptos como ejecutable, proceso, loader, ELF, PE, .text, .data, .bss, stack, heap, memoria virtual, Entry Point, ABI, opcode y registros no son temas completamente independientes.
Son piezas de una misma historia:
cómo un programa almacenado se transforma en algo que el procesador puede ejecutar.
Y quizá esa sea la mejor manera de mirar el terminal a partir de ahora.
En lugar de pensar únicamente:
«
cdhace esto,mkdirhace aquello...»
puedes empezar a preguntarte:
«¿Qué programa recibió este comando? ¿Qué hizo el sistema operativo? ¿Qué proceso está involucrado? ¿Dónde está esto en la memoria? ¿Y qué está ejecutando realmente la CPU?»
Es en ese momento cuando el ordenador empieza a dejar de parecer una caja negra.
Sigue estudiando programación
Si estás empezando ahora y todavía sientes que muchos conceptos parecen desconectados, el siguiente paso es construir una base sólida de lógica y programación.
Puedes descargar gratis el eBook de Lógica para principiantes y continuar tu recorrido de aprendizaje.
Descargar el eBook gratuito de Lógica para principiantes
Y, para profundizar tus conocimientos de programación, también puedes continuar con los contenidos de Programación en Python, Funciones en Python y Estructuras condicionales en Python.