
Quando comecei a programar, uma das coisas que mais me confundia não era necessariamente escrever código.
Era entender o que o computador estava fazendo com aquilo que eu digitava.
Comandos aparentemente simples como:
pwd
cd
mkdir
touch
pareciam apenas palavras que eu precisava decorar.
Eu sabia que pwd mostrava uma pasta, que cd mudava de diretório, que mkdir criava uma pasta e que touch podia criar um arquivo. Mas uma pergunta continuava:
O que realmente acontece depois que eu pressiono Enter?
E essa pergunta leva a uma questão ainda maior:
Como o computador executa um programa?
A resposta envolve muito mais do que simplesmente "a CPU executa o código".
Existe uma sequência envolvendo o terminal, o shell, o sistema operacional, processos, arquivos executáveis, loader, memória virtual, runtime, entry point, registradores e CPU.
Neste artigo, vamos construir essa explicação passo a passo.
Antes do programa: o que acontece quando você usa o terminal?

Vamos começar por algo que provavelmente você já fez.
No Linux, podemos abrir um terminal e executar:
pwdO comando mostra o diretório atual.
Depois:
mkdir projetoCriamos um diretório chamado projeto.
Podemos entrar nele:
cd projetoE criar um arquivo:
touch programa.txtÀ primeira vista, parece que o terminal simplesmente "entende" essas palavras.
Mas ele não funciona dessa maneira.
Quando você digita:
mkdir projetohá um programa chamado shell envolvido nessa interação.
O shell é o programa que recebe os comandos que você digita e coordena a execução deles.
No Linux, exemplos comuns de shell incluem Bash, Zsh e outros.
No Windows, podemos utilizar ambientes como o PowerShell.
Isso já nos dá uma primeira ideia importante:
O terminal é o ambiente onde interagimos; o shell é o programa que interpreta nossa entrada e participa da execução dos comandos.
E aqui começa nossa jornada.
O que acontece quando pressionamos Enter?
Imagine que você digite:
mkdir projetoe pressione Enter.
Uma simplificação do caminho é:
Você
  ↓
Terminal
  ↓
Shell
  ↓
Sistema operacional
  ↓
Operação solicitada
  ↓
Sistema de arquivos
O detalhe importante é que nem todo comando funciona exatamente da mesma maneira.
Alguns comandos podem ser implementados pelo próprio shell como built-ins.
Por exemplo, cd normalmente precisa ser tratado pelo próprio shell porque alterar o diretório de trabalho do processo do shell é justamente o que permite que os comandos seguintes sejam executados a partir daquele diretório.
Outros comandos podem ser programas separados.
O ponto central é:
digitar algo no terminal não significa que a CPU recebeu diretamente aquele texto como uma instrução de máquina.
Existe uma camada de software entre você e o processador.
E essa ideia será importante quando chegarmos à execução de programas.
Programa e processo não são a mesma coisa
Essa é uma das distinções mais importantes deste artigo.
Imagine que você tenha um arquivo executável.
Esse arquivo é um programa armazenado.
Quando o sistema operacional começa a executá-lo, temos um processo.
Uma maneira simples de pensar é:
Programa
= algo armazenado

Processo
= uma instância desse programa em execução
Por exemplo, você pode ter um executável de um editor de texto instalado no computador.
O arquivo existe no armazenamento mesmo quando o editor está fechado.
Quando você abre o editor, o sistema operacional cria uma instância em execução.
Essa instância possui recursos próprios, como espaço de endereçamento virtual, informações de execução, memória e identificadores.
No Linux, por exemplo, processos possuem um PID, o identificador do processo.
Portanto:
arquivo executável
       ↓
   carregamento
       ↓
     processo
       ↓
    execução
Essa diferença resolve uma confusão comum de quem está começando:
o arquivo no disco não é a mesma coisa que o processo que está executando.
O que é um arquivo executável?
Um arquivo executável não é simplesmente um arquivo de texto contendo comandos.
Ele possui uma estrutura que permite ao sistema operacional descobrir informações necessárias para colocá-lo em execução.
Dependendo do sistema operacional e da plataforma, diferentes formatos podem ser utilizados.
No Linux, um dos principais é o ELF — Executable and Linkable Format.
No Windows, encontramos o PE — Portable Executable.
No ecossistema da Apple, existe o Mach-O.
Esses formatos possuem informações estruturais que ajudam o sistema a entender como aquele arquivo deve ser utilizado.
No caso do PE, por exemplo, a documentação da Microsoft descreve cabeçalhos, tabela de seções, informações de importação/exportação e dados necessários para a imagem executável.
No ELF, a estrutura de program headers descreve segmentos relacionados à criação da imagem do processo, incluindo informações necessárias para carregar o programa e preparar sua representação em memória.
É importante perceber a mudança de perspectiva:
Não é apenas:

"arquivo com código"

É:

"arquivo estruturado que contém informações
necessárias para formar um programa em execução"
ELF, PE e Mach-O
Os formatos não são simplesmente três nomes diferentes para exatamente a mesma coisa.
Eles pertencem a ecossistemas diferentes.
| Sistema/ecossistema | Formato comum |
|---|---|
| Linux/Unix-like | ELF |
| Windows | PE |
| Apple | Mach-O |
O ELF é utilizado em muitos sistemas Unix-like e descreve tanto objetos quanto executáveis e objetos compartilhados.
O PE é o formato utilizado para imagens executáveis e outros arquivos relacionados no Windows. A própria Microsoft documenta sua estrutura em termos de cabeçalhos, seções, diretórios de dados, importações e relocação.
O Mach-O é utilizado no ecossistema Apple. A documentação da Apple, por exemplo, trata das arquiteturas de código executável suportadas por um bundle e de seu carregamento.
Para o nosso objetivo, não precisamos decorar todos os campos desses formatos.
Precisamos entender por que eles existem.
O sistema operacional precisa de informações estruturadas para transformar o conteúdo armazenado em uma imagem de processo que possa ser executada.
O que o loader faz?
Agora chegamos a uma peça fundamental:
o loader.
O loader participa do processo de transformar o executável armazenado em uma representação que pode ser executada pelo processo.
Imagine:
Executável no armazenamento
          ↓
       Loader
          ↓
Imagem do processo na memória
          ↓
       Execução
No ELF, a especificação descreve justamente essa relação entre o arquivo e a criação de uma representação dinâmica do programa, chamada process image. Os segmentos descritos pelos program headers são utilizados para preparar essa imagem em memória.
Isso é muito importante.
O computador não simplesmente pega o arquivo inteiro e "joga dentro da RAM".
Ele precisa interpretar sua estrutura e preparar diferentes regiões do espaço de endereçamento do processo.
Além disso, programas frequentemente dependem de bibliotecas compartilhadas e outras estruturas que também precisam participar da inicialização.
Como o programa é organizado na memória?
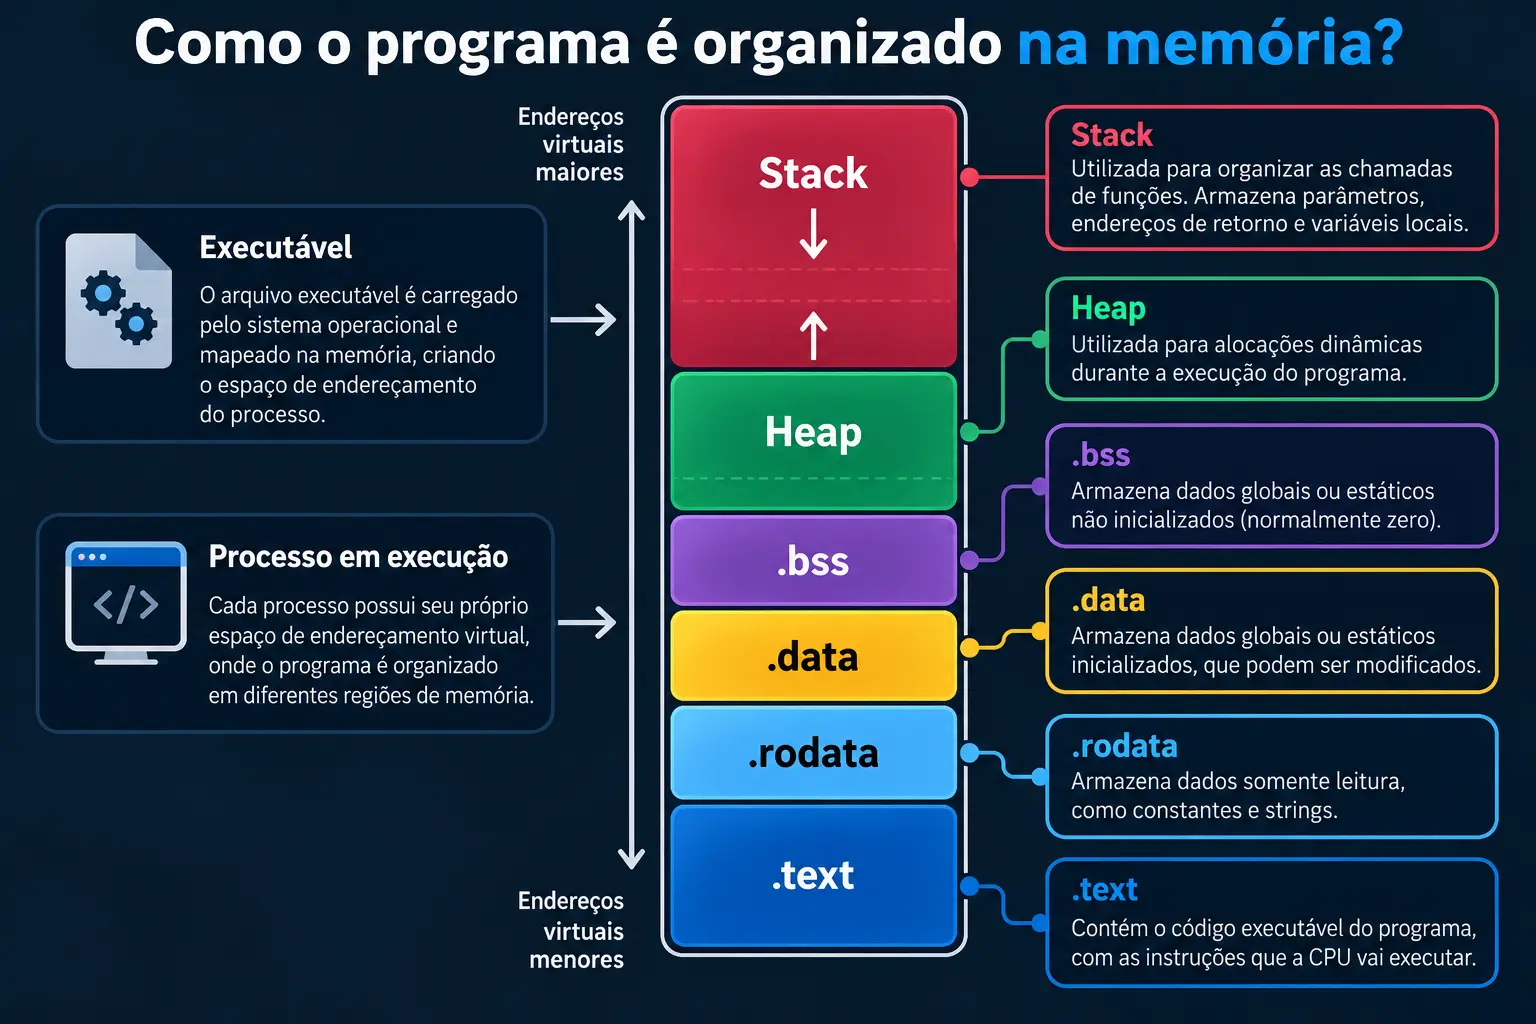
Quando um processo está em execução, seu espaço de memória não é simplesmente uma grande caixa sem organização.
Existem diferentes regiões com funções diferentes.
Uma representação didática é:
Endereços virtuais maiores
┌─────────────────────────┐
│          Stack          │
│          ↓              │
│                         │
│                         │
│          ↑              │
│          Heap           │
├─────────────────────────┤
│ Dados inicializados     │
│ .data                   │
├─────────────────────────┤
│ Dados somente leitura   │
│ .rodata                 │
├─────────────────────────┤
│ Dados não inicializados │
│ .bss                    │
├─────────────────────────┤
│ Código                  │
│ .text                   │
└─────────────────────────┘
Endereços virtuais menores
Essa representação é conceitual. A organização real depende da plataforma, do formato do executável, do compilador, do linker, do sistema operacional e de outros fatores.
Mesmo assim, ela ajuda a entender as responsabilidades.
.text: onde fica o código
A região .text normalmente está associada ao código executável do programa.
É ali que encontramos as instruções que, em algum momento, poderão ser executadas pela CPU.
Por exemplo, uma função escrita em uma linguagem de programação acaba, direta ou indiretamente, sendo representada por instruções que o processador consegue executar.
Mas ainda existe uma diferença enorme entre:
print("Olá")e aquilo que a CPU efetivamente executa.
A CPU não recebe a palavra print como uma instrução nativa.
Existe uma cadeia de software entre a linguagem que utilizamos e as instruções da arquitetura do processador.
Neste artigo, nosso foco não é aprofundar essa transformação, mas entender o que acontece quando já existe código executável que pode ser carregado e executado.
.data, .rodata e .bss
Além do código, o programa pode precisar armazenar dados.
.data
É normalmente associada a dados globais ou estáticos que possuem valores inicializados e podem ser modificados.
.rodata
O nome vem de read-only data.
É utilizada para dados que precisam ser tratados como somente leitura em muitas toolchains, como determinadas constantes e strings.
.bss
É tradicionalmente associada a dados globais ou estáticos que não precisam ocupar espaço equivalente no arquivo para representar seus valores iniciais, normalmente zero.
Essas regiões ajudam a mostrar algo importante:
Um programa em execução é muito mais do que suas instruções.
Ele precisa de código, dados, memória para chamadas de funções, alocação dinâmica e diversas estruturas de suporte.
Memória virtual: o endereço que o programa enxerga
Aqui aparece um conceito que costuma causar bastante confusão no começo:
memória virtual.
Quando um programa acessa um endereço, esse endereço faz parte do espaço de endereçamento virtual do processo.
Isso não significa necessariamente que aquele número corresponda diretamente a uma posição física específica da RAM.
O sistema utiliza mecanismos de memória virtual para mapear endereços virtuais para memória física e outros recursos.
No Linux, é possível observar as regiões de memória mapeadas de um processo através de /proc/PID/maps. A documentação do kernel descreve esse arquivo como contendo as regiões de memória atualmente mapeadas e suas permissões.
Por exemplo, uma saída pode conter regiões identificadas como:
[heap]
[stack]
e também regiões associadas a arquivos e bibliotecas.
Isso torna o conceito muito mais concreto:
o processo possui um espaço de endereçamento organizado, e o sistema operacional gerencia os mapeamentos desse espaço.
Stack e Heap
Dois termos aparecem praticamente em qualquer conversa sobre memória:
stack e heap.
Stack
A stack é utilizada para organizar dados relacionados à execução das funções.
Quando uma função chama outra função, existe uma série de informações que precisam ser mantidas: parâmetros, endereços de retorno e outros dados necessários à execução.
A stack ajuda a organizar esse tipo de informação.
Heap
O heap está associado à memória utilizada para alocações dinâmicas.
Quando um programa precisa obter memória durante sua execução, mecanismos de alocação podem utilizar o heap.
A diferença simplificada é:
Stack
→ organização das chamadas de execução

Heap
→ memória dinâmica
Não pense nisso como duas "gavetas físicas" dentro da RAM.
São regiões conceituais do espaço de memória do processo.
Entry Point: onde a execução começa?
Agora chegamos a uma pergunta interessante:
Se o executável possui milhares ou milhões de bytes, por onde o computador começa?
É aí que entra o Entry Point.
O executável possui informações que indicam o ponto inicial da imagem executável.
Esse endereço permite que a execução seja iniciada a partir de uma posição conhecida.
Mas existe uma sutileza importante.
O entry point não precisa ser simplesmente a primeira linha da função que você escreveu.
Antes de seu código principal ser executado, pode existir uma etapa de inicialização envolvendo runtime, bibliotecas, preparação do ambiente e argumentos.
Por isso, conceitos como:
Entry Point
Runtime
main()
não devem ser tratados como sinônimos.
Dependendo da linguagem e da plataforma, existe uma cadeia de inicialização antes de chegarmos ao código que reconhecemos como "nosso programa".
O que é runtime?
Runtime significa, de forma geral, o conjunto de mecanismos necessários durante a execução de um programa.
Dependendo da linguagem e do ambiente, o runtime pode cuidar de diferentes responsabilidades.
Ele pode participar da inicialização do programa, gerenciamento de estruturas, suporte à linguagem, tratamento de exceções, threads, memória e outras operações.
Por isso, quando pensamos:
"Eu escrevi uma função e o computador executou."
existe uma quantidade considerável de infraestrutura entre essas duas coisas.
O código que você escreveu faz parte de um ambiente de execução muito maior.
Bibliotecas compartilhadas
Outro detalhe importante aparece quando o programa depende de código externo.
Em vez de colocar absolutamente tudo dentro do executável, sistemas podem utilizar bibliotecas compartilhadas.
Isso permite que diferentes programas utilizem componentes comuns.
Durante o carregamento, essas bibliotecas podem ser mapeadas no espaço de endereçamento do processo.
No Linux, por exemplo, /proc/PID/maps pode mostrar regiões de memória associadas a bibliotecas carregadas. A documentação do kernel mostra justamente mapeamentos de arquivos e regiões como heap e stack nesse espaço.
Isso explica por que a execução de um programa pode envolver muito mais do que um único arquivo.
E o que é relocação?
Agora temos outro conceito importante:
relocação.
Um programa pode conter referências que precisam ser ajustadas quando ele é colocado em determinado endereço ou quando componentes diferentes precisam ser conectados.
A relocação é um dos mecanismos utilizados para resolver esse tipo de situação.
No formato PE, por exemplo, a especificação da Microsoft documenta informações de base relocations.
No ELF, o processo de preparar a imagem do programa também envolve resolver referências entre objetos que compõem o processo.
Para o iniciante, não é necessário decorar cada tipo de relocação.
A ideia principal é:
o endereço representado no arquivo e o endereço efetivamente utilizado durante a execução podem exigir ajustes.
E onde entra o kernel?
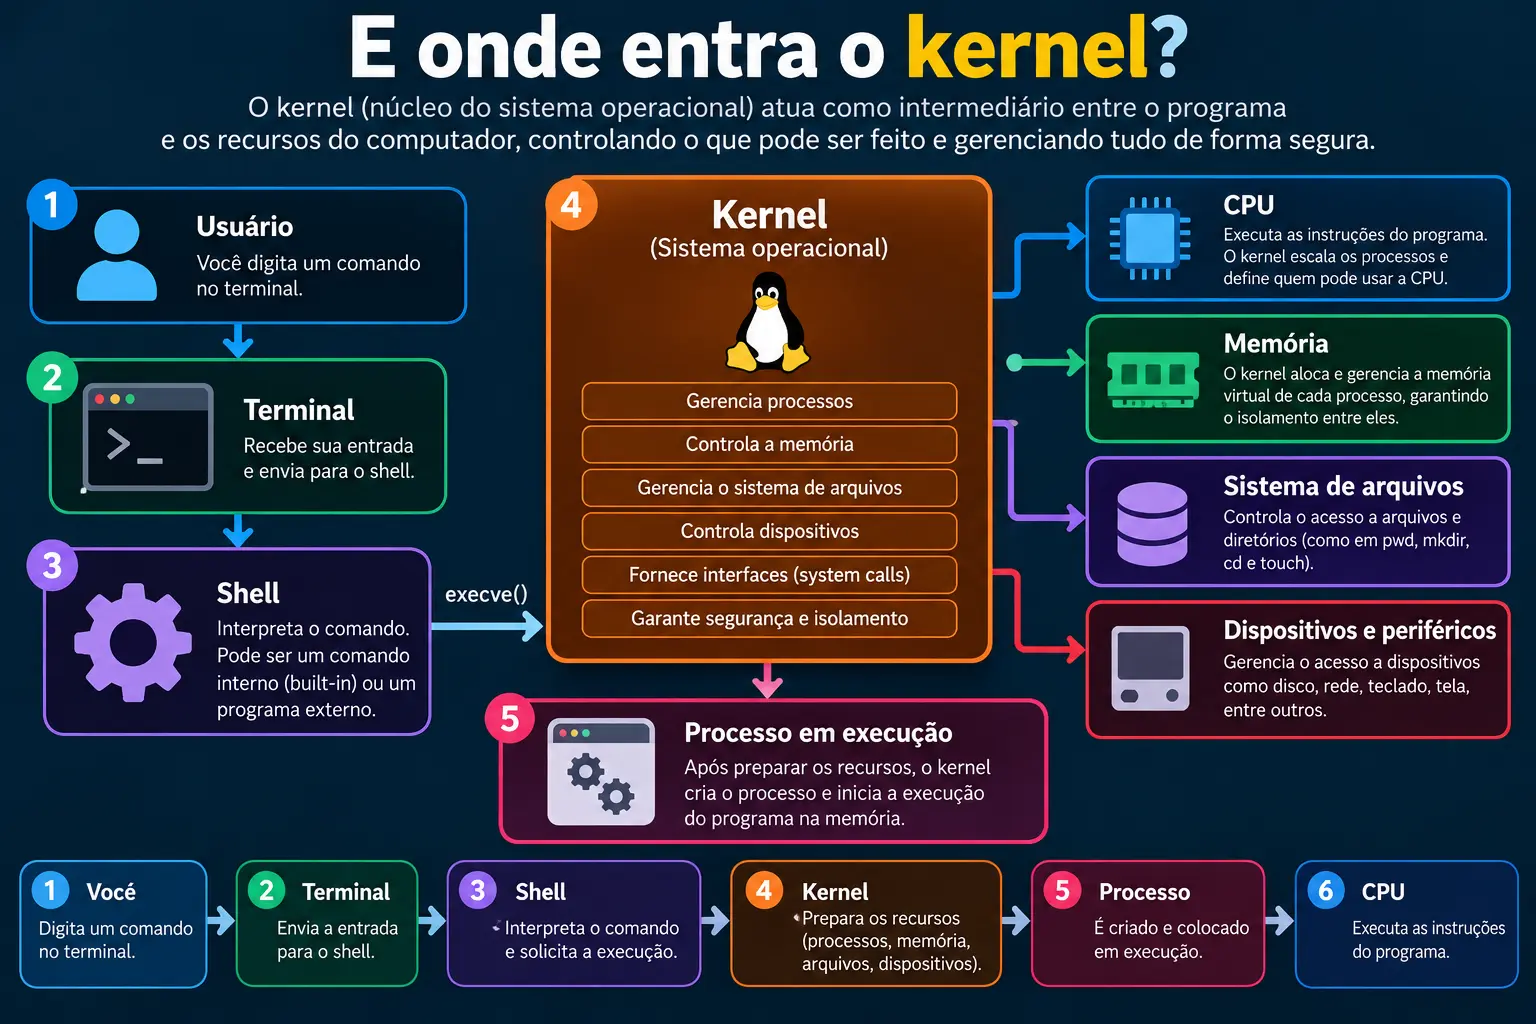
Até aqui falamos bastante sobre o programa.
Agora precisamos olhar para o sistema operacional.
O kernel é o núcleo do sistema operacional e possui responsabilidades fundamentais relacionadas ao gerenciamento dos recursos do computador.
Quando um programa precisa interagir com recursos controlados pelo sistema operacional, ele não simplesmente acessa tudo diretamente.
Existem interfaces entre o programa e o kernel.
No Linux, por exemplo, uma dessas interfaces fundamentais são as system calls.
Um exemplo clássico é execve.
A documentação do Linux descreve execve() como a chamada que executa o programa indicado pelo caminho, substituindo a imagem do processo chamador por uma nova imagem de programa, com stack, heap e segmentos de dados inicializados novamente.
Isso é uma peça fundamental para entender a execução.
Um detalhe importante sobre o shell
Voltemos ao nosso terminal.
Você digita:
./programaO shell não pega o texto ./programa e entrega diretamente à CPU.
Existe uma sequência de operações.
De forma simplificada:
Você digita ./programa
          ↓
Shell interpreta o comando
          ↓
Sistema operacional recebe uma solicitação
          ↓
Programa é localizado
          ↓
Executável é analisado
          ↓
Imagem do processo é preparada
          ↓
Memória é configurada
          ↓
Bibliotecas/runtime são preparados
          ↓
Execução começa
No Linux, execve() é uma das interfaces fundamentais dessa transição.
Isso é muito diferente da ideia inicial:
"Eu digitei um comando e o computador executou."
Na verdade, uma cadeia inteira foi colocada em movimento.
Como a CPU realmente executa o programa?
Agora chegamos ao ponto final da nossa jornada.
CPU.
Depois que o programa está preparado para execução, o processador começa a executar instruções da arquitetura para a qual aquele código foi produzido.
Essas instruções são representadas em nível de máquina por sequências de bits/bytes.
Uma instrução pode ser representada por um opcode e outros campos que determinam operação, operandos e modos de endereçamento, dependendo da arquitetura.
A CPU trabalha com registradores, que são pequenas áreas de armazenamento internas ao processador utilizadas para diversos fins durante a execução.
Entre outras coisas, existe um registrador ou mecanismo arquitetural relacionado ao endereço da próxima instrução a ser executada.
A ideia simplificada é:
Memória
  ↓
Instrução
  ↓
CPU
  ↓
Decodificação
  ↓
Execução
  ↓
Resultado
  ↓
Próxima instrução
Em uma visão simplificada, podemos imaginar o ciclo como:
buscar
  ↓
decodificar
  ↓
executar
  ↓
avançar
  ↓
buscar novamente
A implementação real das CPUs modernas é muito mais sofisticada, envolvendo pipeline, execução fora de ordem, caches, previsão de desvios e outros mecanismos.
Mas essa simplificação é suficiente para entender a ideia fundamental:
A CPU não executa diretamente o arquivo executável como um todo. Ela executa instruções de máquina a partir do espaço de memória preparado para o processo.
Então o que é um opcode?
O opcode identifica a operação que uma instrução de máquina representa.
Imagine uma instrução conceitual como:
somarA CPU não recebe a palavra "somar" como texto.
A arquitetura define uma representação binária para instruções.
Dependendo da arquitetura, os bytes podem representar operações como:
mov
add
sub
jmp
call
ret
Os nomes acima são representações em assembly usadas por humanos.
A CPU trabalha com a codificação binária definida pela arquitetura.
É nesse ponto que podemos finalmente conectar programação de alto nível com hardware:
Código que você escreve
        ↓
Software / ferramentas
        ↓
Código executável
        ↓
Instruções de máquina
        ↓
CPU
E os registradores?
Os registradores são fundamentais para a execução.
Uma CPU possui diversos registradores com funções diferentes.
Alguns podem armazenar valores temporários.
Outros podem participar de operações aritméticas.
Outros possuem funções específicas relacionadas ao controle da execução.
Por exemplo, a arquitetura pode possuir um registrador utilizado para acompanhar a localização da próxima instrução.
Isso ajuda a entender uma coisa importante:
a CPU não trabalha apenas com a memória RAM.
Ela possui estado interno.
Durante a execução, esse estado muda continuamente.
ABI: como diferentes partes do software conversam?
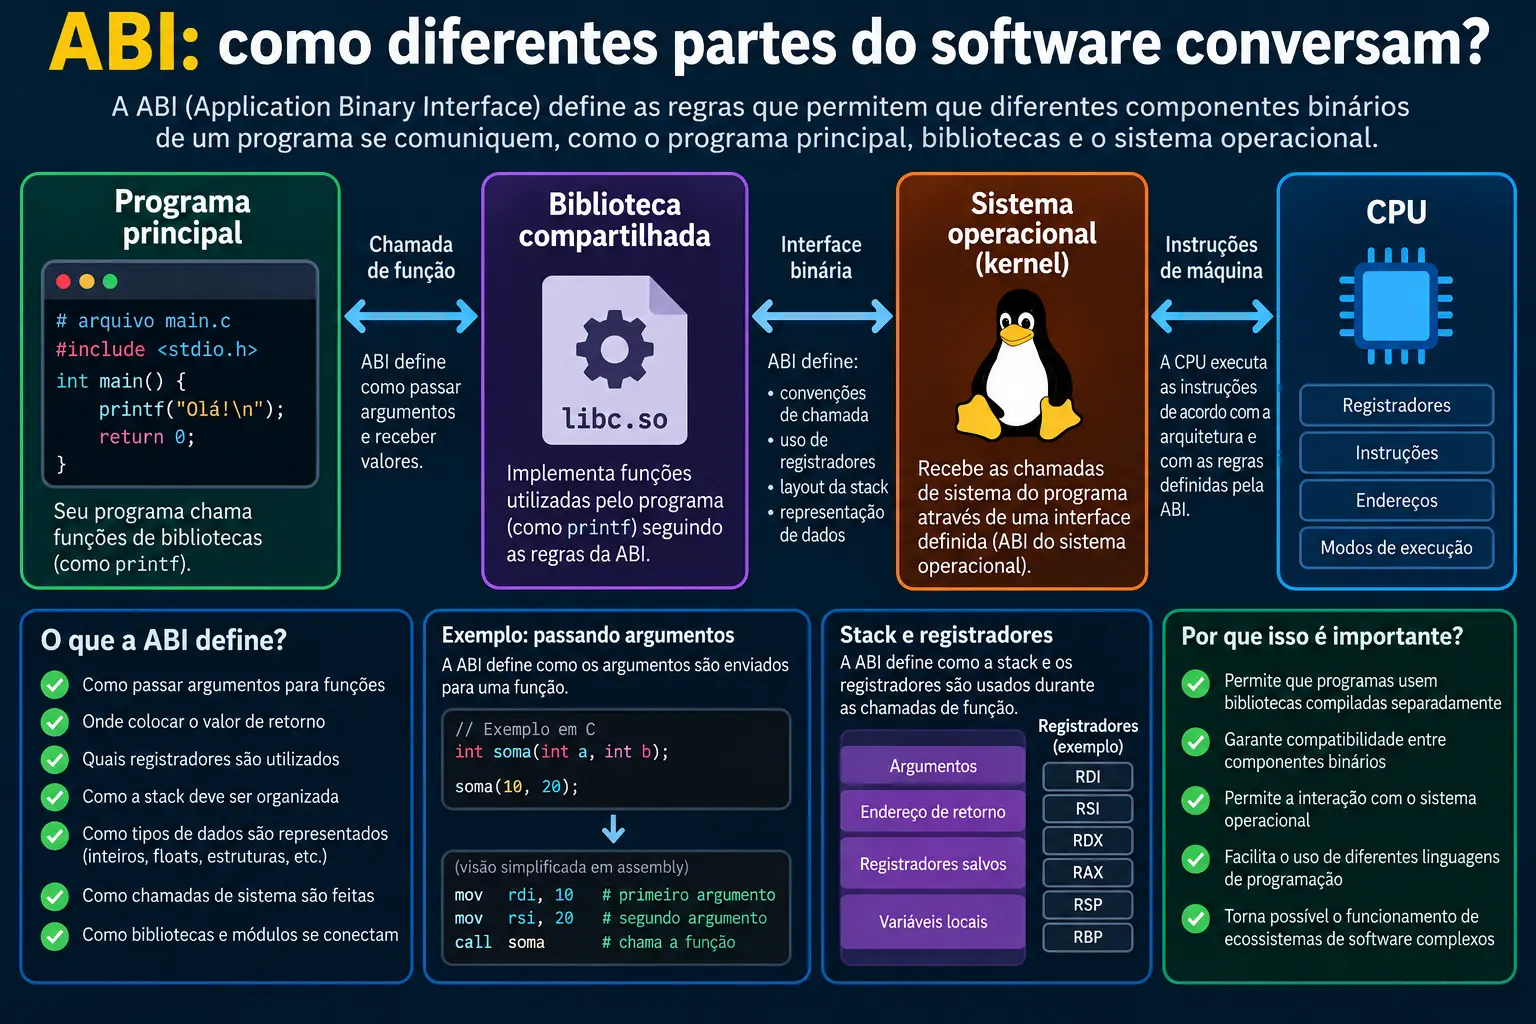
Outro conceito que aparece quando descemos para esse nível é a ABI — Application Binary Interface.
A ABI define regras importantes sobre como componentes binários interagem.
Ela pode estabelecer, entre outras coisas:
-
como argumentos são passados;
-
onde valores de retorno são colocados;
-
quais registradores possuem determinadas responsabilidades;
-
como chamadas de funções funcionam;
-
como determinados tipos são representados.
Isso é importante porque um programa não vive necessariamente sozinho.
Ele pode chamar bibliotecas.
Bibliotecas podem chamar outras bibliotecas.
Componentes diferentes precisam concordar sobre determinadas regras.
A ABI ajuda a estabelecer esse contrato.
Onde entram Python e Rust?
Agora podemos voltar às linguagens de programação.
Quando você escreve:
print("Olá")ou um pequeno programa em Rust, você está trabalhando em uma camada muito mais próxima do desenvolvedor do que a CPU.
Essas linguagens fornecem abstrações para que você não precise escrever manualmente todas as instruções de máquina.
No caso de Rust, existe uma relação particularmente interessante com executáveis nativos e sistemas de baixo nível.
Mas isso não significa que Rust ou Python sejam "o que o computador entende".
O computador, no nível da CPU, trabalha com as instruções definidas pela arquitetura do processador.
A linguagem é uma das camadas que utilizamos para produzir ou controlar software que, em algum ponto, chegará às instruções executáveis.
Neste artigo, não precisamos transformar isso em uma discussão sobre compiladores versus interpretadores.
O objetivo é enxergar as camadas.
E onde entra o LUME?
O LUME pode ser colocado nessa mesma visão como um conceito relacionado ao ecossistema que você está estudando.
Ele não muda a sequência fundamental que estamos tentando entender:
programa
  ↓
sistema operacional
  ↓
processo
  ↓
memória
  ↓
instruções
  ↓
CPU
O mais importante, para quem está começando, é não tentar decorar todos os nomes de uma vez.
Primeiro entenda a relação entre as camadas.
Depois você pode aprofundar cada uma delas.
O caminho completo: do terminal até a CPU
Agora podemos juntar tudo.
Imagine que você tenha um programa executável e execute:
./programaO caminho conceitual é:
┌─────────────────────────┐
│         Você            │
│   digita no terminal    │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│        Terminal         │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│          Shell          │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│   Sistema operacional   │
│         / kernel        │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│      Executável         │
│       ELF / PE          │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│         Loader          │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│        Processo         │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│     Memória virtual     │
│ .text .data .bss heap   │
│        stack etc.       │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│    Runtime / inicial.   │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│      Entry Point        │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│ Instruções de máquina   │
│      / opcodes          │
└────────────┬────────────┘
             ↓
┌─────────────────────────┐
│       Registradores     │
│          + CPU          │
└─────────────────────────┘
Esse é o mapa mental que vale guardar.
E onde ficam pwd, cd, mkdir e touch nessa história?
Agora podemos voltar à dificuldade que motivou este artigo.
Você começou aprendendo comandos como:
pwd
cd
mkdir
touch
E talvez tenha parecido que o objetivo era simplesmente decorar:
pwd  → mostra diretório
cd   → muda diretório
mkdir → cria diretório
touch → cria arquivo
Mas agora podemos enxergar esses comandos de outra maneira.
Eles são uma porta de entrada para entender o computador.
Quando você digita um comando, existe um software recebendo sua entrada.
Esse software interage com o sistema operacional.
O sistema operacional gerencia recursos.
Processos possuem memória e estado.
Executáveis possuem formatos estruturados.
O loader prepara programas para execução.
A memória virtual organiza o espaço de endereçamento.
O runtime pode preparar o ambiente de execução.
O entry point indica onde a execução começa.
E finalmente a CPU executa instruções de máquina.
Por isso, aprender terminal não deveria ser apenas decorar comandos.
O terminal pode ser uma janela para entender como o sistema operacional funciona.
A principal diferença entre "programa" e "processo"
Se você guardar apenas uma distinção deste artigo, guarde esta:
Programa
→ código e dados armazenados

Processo
→ programa em execução + estado + recursos
Um mesmo programa pode originar vários processos.
Por exemplo, você pode abrir várias instâncias de um aplicativo.
O arquivo executável continua sendo um arquivo.
Cada execução cria uma instância com seu próprio contexto de execução.
O que você deve guardar
Você não precisa sair deste artigo decorando todas as estruturas do ELF, todos os campos do PE ou todos os registradores de uma CPU.
O primeiro objetivo é construir um mapa mental.
Quando você executar um programa, pense:
1. Existe alguma forma de solicitar a execução.
No terminal, isso pode acontecer por meio do shell.
2. Existe um arquivo ou outro mecanismo que representa o programa.
Em sistemas tradicionais, executáveis possuem formatos estruturados como ELF ou PE.
3. O sistema operacional participa da criação da execução.
Ele precisa preparar recursos e memória para o processo.
4. O loader prepara a imagem do programa.
Partes do executável e bibliotecas necessárias podem ser mapeadas no espaço de endereçamento.
5. O processo possui memória virtual.
Código, dados, heap, stack e outras regiões fazem parte desse espaço.
6. Existe um ponto de início.
O entry point participa da definição de onde a execução começa.
7. O software inicializa seu ambiente.
Runtime e outras estruturas podem participar dessa fase.
8. A CPU executa instruções.
A partir daí entramos no nível de opcodes, registradores e arquitetura do processador.
O caminho completo pode ser resumido assim:
Terminal
   ↓
Shell
   ↓
Sistema operacional
   ↓
Executável
   ↓
Loader
   ↓
Processo
   ↓
Memória virtual
   ↓
Runtime
   ↓
Entry Point
   ↓
Instruções
   ↓
CPU
E essa sequência é muito mais útil do que decorar definições isoladas.
Conclusão
A grande mudança de perspectiva é esta:
Quando você digita:
mkdir projetoou:
./programanão está simplesmente "mandando uma ordem para a CPU".
Existe uma arquitetura inteira entre você e o processador.
Você interage com um terminal.
O shell participa da interpretação e execução dos comandos.
O sistema operacional gerencia os recursos.
O executável possui uma estrutura.
O loader prepara o programa.
Um processo é criado ou transformado para executar aquela imagem.
A memória virtual organiza o espaço utilizado pelo processo.
Runtime e bibliotecas podem participar da inicialização.
O entry point define um ponto de início da execução.
E finalmente a CPU trabalha com instruções, registradores e dados.
É por isso que conceitos como executável, processo, loader, ELF, PE, .text, .data, .bss, stack, heap, memória virtual, Entry Point, ABI, opcode e registradores não são assuntos completamente separados.
Eles são peças de uma mesma história:
como um programa armazenado se transforma em algo que o processador consegue executar.
E talvez essa seja a melhor forma de olhar para o terminal daqui para frente.
Em vez de pensar apenas:
"
cdfaz isso,mkdirfaz aquilo..."
você pode começar a perguntar:
"Qual programa recebeu esse comando? O que o sistema operacional fez? Qual processo está envolvido? Onde isso está na memória? E o que a CPU está realmente executando?"
É nesse momento que o computador começa a deixar de parecer uma caixa preta.
Continue estudando programação
Se você está começando agora e ainda sente que muitos conceitos parecem desconectados, o próximo passo é construir uma base sólida de lógica e programação.
Você pode baixar gratuitamente o eBook de Lógica para Iniciantes e continuar sua jornada de estudos.
Baixar o eBook gratuito de Lógica para Iniciantes
E, para aprofundar sua base em programação, você também pode continuar pelos conteúdos de Programação em Python, Funções em Python e Estruturas Condicionais em Python.